Connectionist Temporal Classification
因为最近做了一些用连续标签做文字识别标签任务的工作,对 ctc 有了一些了解,在此记录一下。
在学习 CTC 的时候,也看了不少博客,但是我觉得讲的最好的还是原论文 Connectionist Temporal Classification: Labelling Unsegmented Sequence Data with Recurrent Neural Networks 解释的最清楚。
对于没接触过这个概念的人,可能加一些例子会更好理解一些。
我就来加一些例子。
背景知识
用实例来说,我们在做 ocr 工作时,我们希望给一行文字的图片让机器识别出来这个图片里面的文字。
语音识别任务中,给了一段语音片段,我们希望能把这段语音识别成可编辑的文字。
但是,在对每个片段进行分类模型训练之前,需要对每个训练样本进行切割标注。
这是项非常繁琐的工作,需要大量的人工,是非常非常大量的人工。
传统文本标工具
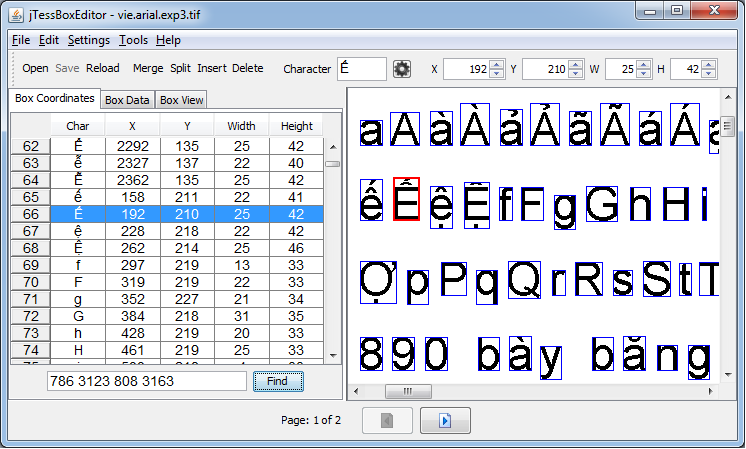
下面是个对文字进行标注的工具,大家可以看一下。如果我们在做文字识别工作时,对每个文字都要明确标出这个字在图片中的位置、高、宽,这将会是一个多么巨大的工作量。
RNNs 在序列学习任务中有着优越的性能,但是它也有一些缺点。
如,在上面描述的那种对输入模型的数据需要预处理的缺点。同时,对 RNNs 的序列也需要一定的整合才能得到最终的预测序列。
而 CTC 解决了对输入序列的单个词的切分和对输入序列的整合工作。
CTC 的优点
- 一句话(多个连续文字),作为一个图片(或者语音)的输入。
- 整合 RNNs 的输出序列,得到一个最优的输出序列。
RNN 的输出
输入序列的切分与标注上面已经举了一个例子,现在举一个输出序列整合的例子。
我们现在有一个图片的输入  。
假设这个图片中每个红都作为 RNN 的一步输入,那么(如果这个模型训练的还不错的话)它的输出序列应该是 hheelloo。
但是,我们知道 RNN 每一步的输出其实都是一组概率分布,。
如,对第一个矩形框的输出概率可能是
时序分类(Temporal Classification)
先给几个定义。
| 符号 | 解释 |
|---|---|
字母表 Alphebat |
|
| 表示输入数据的一个“宽度”,如我们输入的是一个图片时,宽度可以是一个定值。 表示这个串的长度不定 ,如输入图片的长度是未知长度。 | |
| 表示输入数据空间。 | |
| 表示由字母表排列而成的标签集合,我们可以理解成单词表。 | |
| 真实数据空间。 | |
z |
z 是 中的一个样本。 |
x |
x ,表示一个样本输入数据的输入序列。如一个定高图片每一列像素可以认为是一个 。 |
训练样本集,这个集合中的每个样本都是一个 (x, z) 组合 |
|
| 时序分类器。 | |
| 时间片数 |
由上面的定义,我们可以看出,因为输入和输出和长度未必相等,所以没有办法事先把这两种数据对齐。
为了保障输出不少于文字标签,输入网络的样本窗口,应该是小于单个字的宽度。这样输出的结果才至少和
目标
时序分类的目标就是学习
损失函数
用于 CTC 的损失函数是 Lebal Error Rate(LER)。
这里我们需要知道“最小编辑距离(Edit Distance, ED)”这个概念,在 CTC 的损失函数就用到了。
在学习算法的时候,
ED算是一个比较经典的动态规划问题,但在实际工作中其实很少用到这类算法。 所以第一次知道这个算法能用在这里,我还是挺开心的。
损失函数定义如下: 用编辑距离(ED)来衡量文字串的预测情况还是一件蛮符合直观理解的事情。
连接的时序分类(Connectionist Temporal Classification)
写了半天终于到正题了,下面开始讲 CTC!
CTC 网络的 softmax 输出层输出的类别有 种,因为有一个分隔符,比如说是空格。
这个分隔符其实蛮重要的,它可以很好地区分一个输出序列串中,哪些子串是属于同一个文字的图片区域的输出结果。
一个输出序列的概率
首先,我们来看一个实例:输入 x 的长度是 T,每一个帧的维度是 m。模型的输出的长度也是 T,每一帧的维度是 n。其中 m n 可以相同也可以不同。用数学定义我们的这个模型就是:
这里,我们引入几个新的概念:
表示,在时间帧为
t的时候,模型的第k个输出值。 我们可以理解 为,模型认为这次输入的 被认为是字母表 中第k个字母的概率。表示一个输出序列的组合,如 那么每组输入,对应的输出都有 种可能的字母排列,我们用 表示其中一种排列。论文中称这种排列为
path。一种输出组合的概率。公式如下:
如, 的一种可能的输出 hheelloo 的概率可以表示为
一种输出序列的规整
同一种输入对应的多种输出可能会有多种形式。
如 的输出可能是 hheel-loo 也可能是 hh-ee-l-l-oo 等。这里的 - 表示空格。
原论文处理这种情况的规则非常简单 We do this by
simply removing all blanks and repeated labels from the paths:
一句话:把空格和连续重复的字母去掉。
那么
则模型预测标签为:
预测标签的概率
我们可以看到预测标签有很多备选的输出序列,所以预测标签 的概率公式: 其中, 是输出序列规整函数 的反函数。 如,
讲到这里,大家就应该明白 CTC 是怎么工作的了。当然还有很多为了实现而做的工作,有时间再接着写吧。
2018.06.24 之前讲了如何从一个序列输入,到生成一组有重复的序列,再从一组有重复的序列生成标签及标签的出现概率的过程。 下面我想学习一下:
- 从输入,到预测输出的方法。
- 损失函数如何反向传播。
如何构建标签的输出模型,及构建过程中的优缺点。
理想预测模型
按照我的理解,要想找到输出模型,只需要枚举出所有可能的组合(所有使用 去重之后相同的概率加到一起),后把概率最大的那个 作为输出标签就行了。公式如下:
缺点: 计算量大。大约有 种可能,则计算概率、比较概率的计算量就非常大。如 26 个字母表,10 个文字输出就有 种结果。
目前在实践中,还没有找到一种好的代替的上面穷举方式的方法。 不过下面两种方法,在实践中获得了不错的效果。
方法一:使用最优子串的处理结果得到的串,作为输出(贪心策略)
现在来明确一个概念:
- 。把每个时间片的结果中,概率最大的结果拿出来,组成一个串并输出。那么这个输出的串必然是概率最大的串。
这时候,标签输出模型是:
缺点: 我们可以看到,它的依据是使用 rnn 输出概率最大的串,归并之后的结果作为输出标签。 这种方法并不能保障 的概率是最大的。
方法二:搜索最优前缀(此方法为方法一的升级版本)
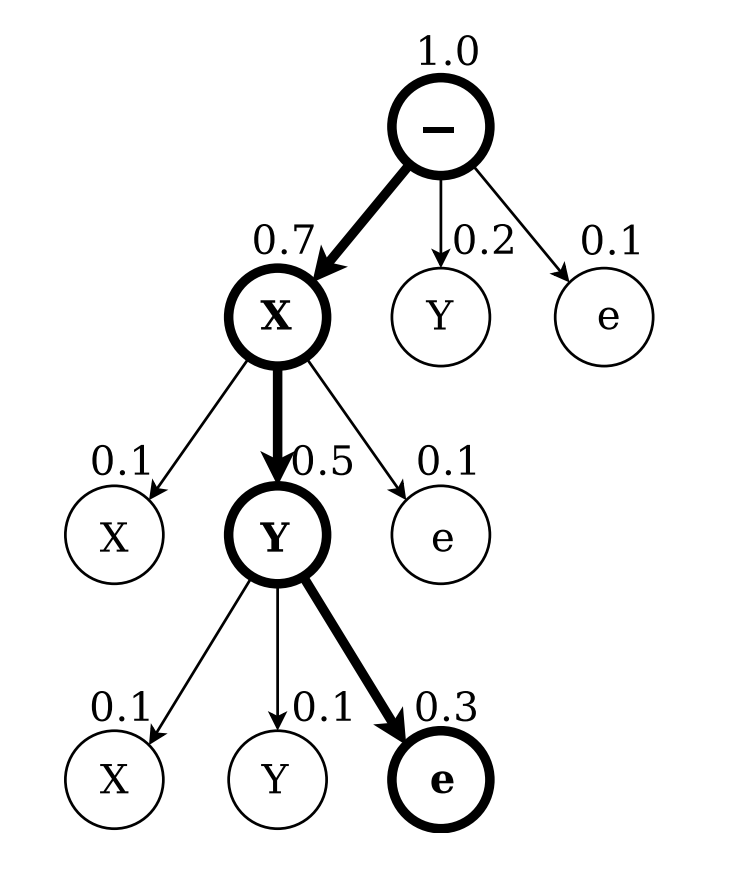 找到第一个字母的最优输出,然后找到以这个字母为开头的子串。并在子串中找到下一个最优的子母。今次下去。
与方法一相比,此方法步步为营,好像更稳重一些。
论文中使用的方法
为了减少计算,论文中使用了一种启发式方法:
- 使用预测出来的空格把预测结果划分成几段。 预测成空格的概率必须大于一个阈值(强条件)
- 对每一段使用方法二。
- 把所有分段结果拼接起来。
缺点: 如果空格的预测概率都不高,这个启发思想就不起作用。 然后退化成方法二了。